Qwen4-Max : Alibaba lance un modèle de 2 400 milliards de paramètres avec un contexte d'un million de tokens
IA · par Insight Nexus · publié le 16 novembre 2026
Alibaba publie Qwen4-Max : MoE de 2 400 milliards de paramètres dont 71 milliards actifs, vision native, un million de tokens de contexte et un coût par tâche en forte baisse. Disponibilité et chiffres.
Le modèle le plus puissant de la famille Qwen
Alibaba a lancé Qwen4-Max le 16 novembre 2026. Selon le groupe chinois, c'est le modèle le plus performant de la famille Qwen à ce jour. Il comprend nativement les images et la vidéo, et accepte un contexte d'un million de tokens. Il est disponible sur QwenCloud (Token Plan et API), ainsi que dans QwenWork et QwenStudio.
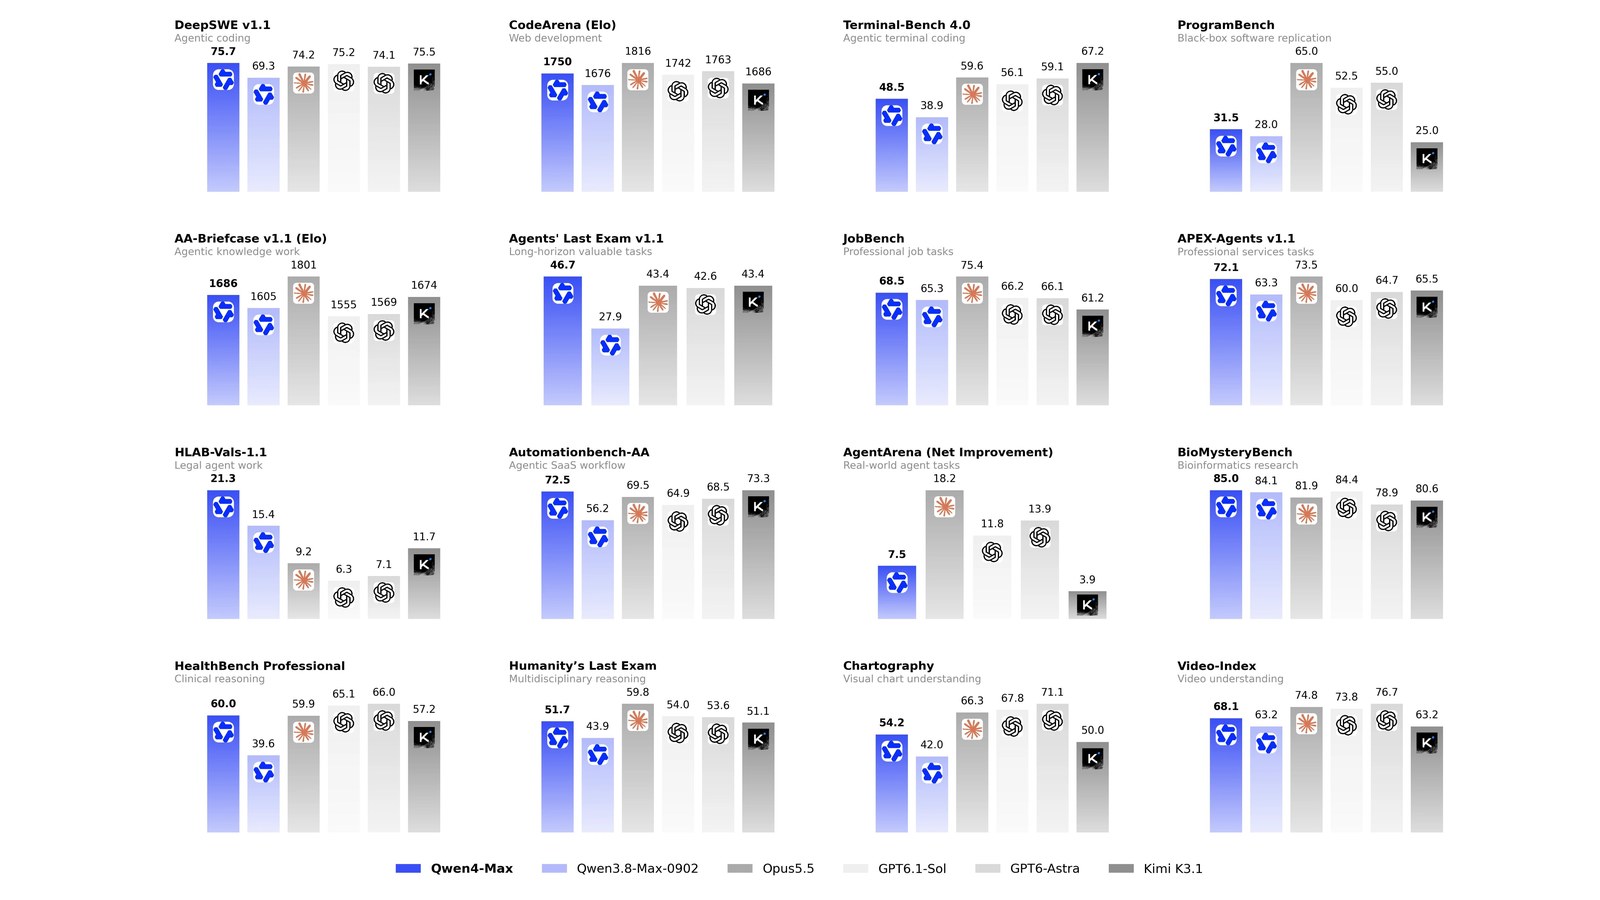
2 400 milliards de paramètres, 71 milliards actifs
Qwen4-Max utilise une architecture Mixture-of-Experts (MoE). Sur ses 2 400 milliards de paramètres au total, il n'en active que 71 milliards par token. C'est 25 % de moins que Qwen3.8-Max, qui a la même taille totale. Alibaba dit avoir revu cette architecture au niveau de l'attention, des connexions résiduelles et des embeddings.
En codage, Qwen4-Max est classé 6e sur Code Arena, un classement de codage en conditions réelles. Alibaba met aussi en avant de bons scores sur Agents' Last Exam, Vals Index, JobBench et Chartography.
Moins de tokens et un coût par tâche plus bas
Alibaba a créé son propre benchmark, Work360, qui couvre des tâches professionnelles dans 721 domaines spécialisés. Sur ce test, Qwen4-Max fait mieux que Qwen3.8-Max avec 35 % de tokens en moins en mode de raisonnement High. Le coût moyen d'une tâche passe de 4,43 à 1,67 dollar. Sur Terminal-Bench 4.0, l'équipe Qwen annonce environ 48 à 49 % de tokens en moins.
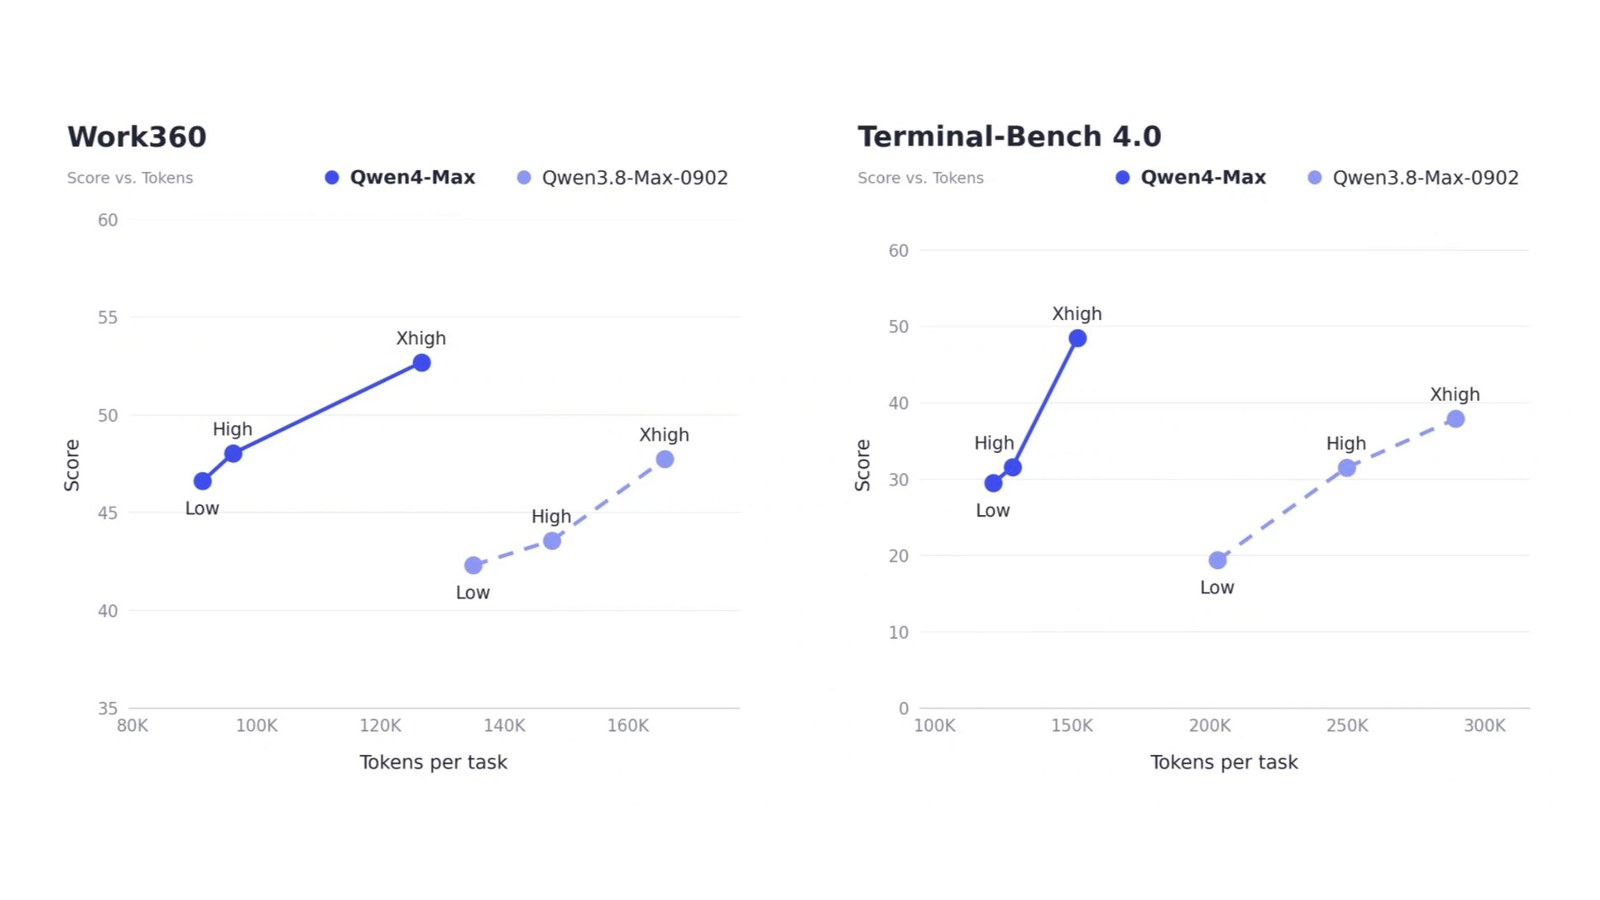
En entrée, les tokens déjà en cache (Implicit Cache Hit) sont facturés 0,075 dollar par million. Alibaba annonce aussi pour bientôt des modèles plus petits de la série Qwen4, en open-weight.
Des agents qui tournent pendant des heures
Alibaba présente Qwen4-Max comme un modèle pour des agents qui travaillent longtemps sans s'arrêter. Dans un test sur le refroidissement des puces, Qwen4 a mené un agent pendant 48 heures d'affilée. Il a trouvé une molécule de liquide de refroidissement, validée ensuite par des expériences. Dans l'industrie automobile, le temps de programmation manuelle d'une pièce serait passé d'environ 475 minutes à 24 minutes.
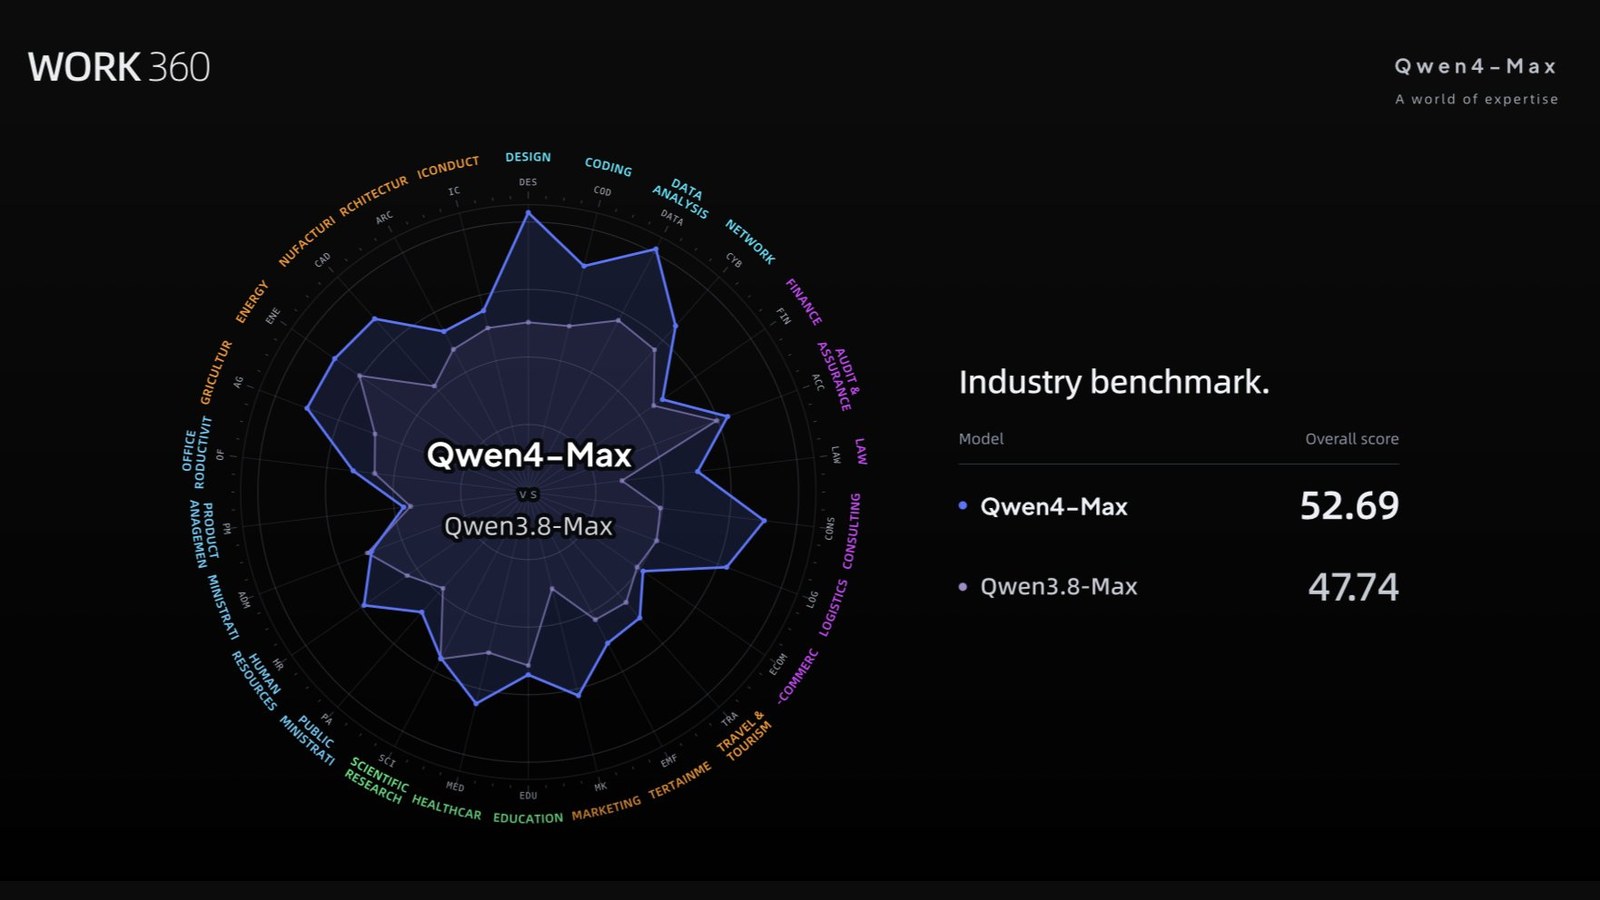
Côté sécurité, Alibaba dit avoir vérifié la sécurité du code pendant l'entraînement. Le groupe a aussi filtré les données liées à la cybersécurité offensive et renforcé les protections contre les risques chimiques, biologiques, radiologiques et nucléaires.
Sources
Communiqué Alibaba Cloud, compte X officiel de Qwen et TechNode. Images : © Alibaba / équipe Qwen.