Olala mini : OVH lance son premier modèle d'IA open source, un 7B qui tourne sur 8 Go de mémoire
IA · par Insight Nexus · publié le 17 novembre 2026
OVH annonce Olala, sa première famille de LLM. Olala mini 7A1B, entraîné sur trois supercalculateurs publics européens, sera publié sous licence Apache 2.0 et sert déjà chez Qwant.
OVH lance Olala, sa première famille de modèles d'IA
Le 17 novembre, OVH a annoncé Olala, sa première famille de LLM. Le premier modèle, Olala mini 7A1B, est un modèle compact bâti sur une architecture inédite. Pour l'hébergeur roubaisien, il prouve que les entreprises européennes peuvent entraîner des LLM agentiques à partir de zéro. Le lancement officiel aura lieu à l'OVHcloud AI Summit, le 19 novembre.
7 milliards de paramètres, 1 milliard actif
Olala mini compte 7 milliards de paramètres, dont 1 milliard activé à chaque requête, répartis entre 256 experts par couche. Il utilise une attention hybride qui combine Differential-TPA et Mamba-3, au format BF16. Comme seule une partie du modèle travaille à chaque requête, il est plus rapide et consomme moins de mémoire :
- il tourne sur un GPU doté d'au moins 8 Go de mémoire ;
- il atteint 160 tokens par seconde sur une RTX A4500 ;
- il fonctionne même sans GPU, sur un simple processeur, à 50 tokens par seconde ;
- sa fenêtre de contexte est de 32 000 tokens.
Le modèle sera publié en open source sur Hugging Face, sous licence Apache 2.0, avec ses poids, son modèle de base pré-entraîné, son rapport technique et sa documentation de conformité à l'AI Act.
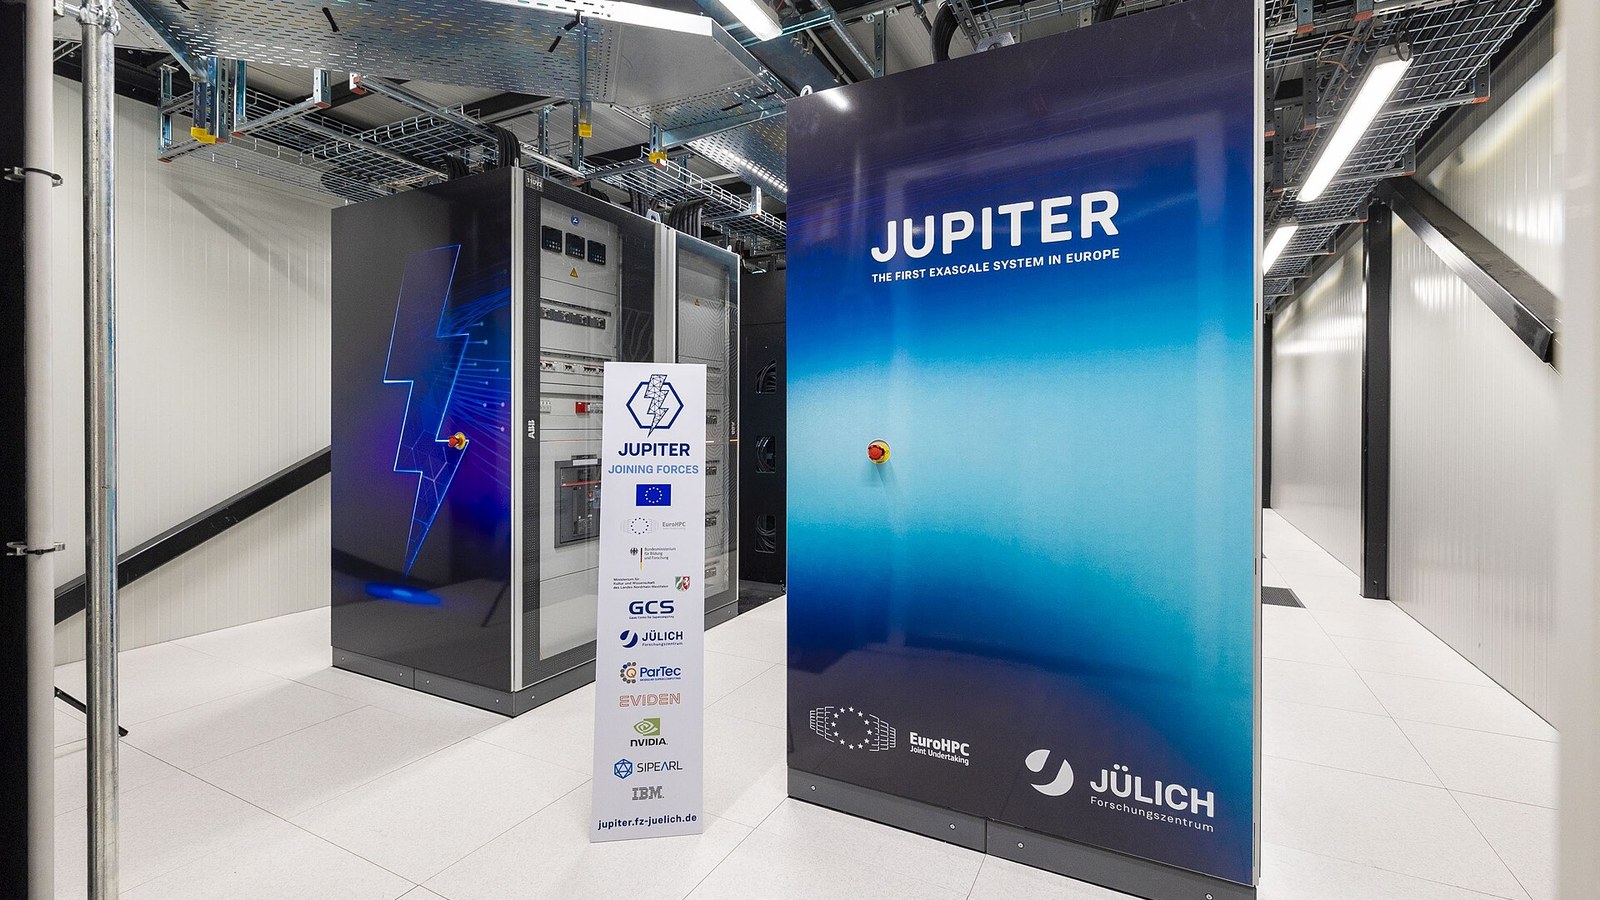
Entraîné sur trois supercalculateurs publics
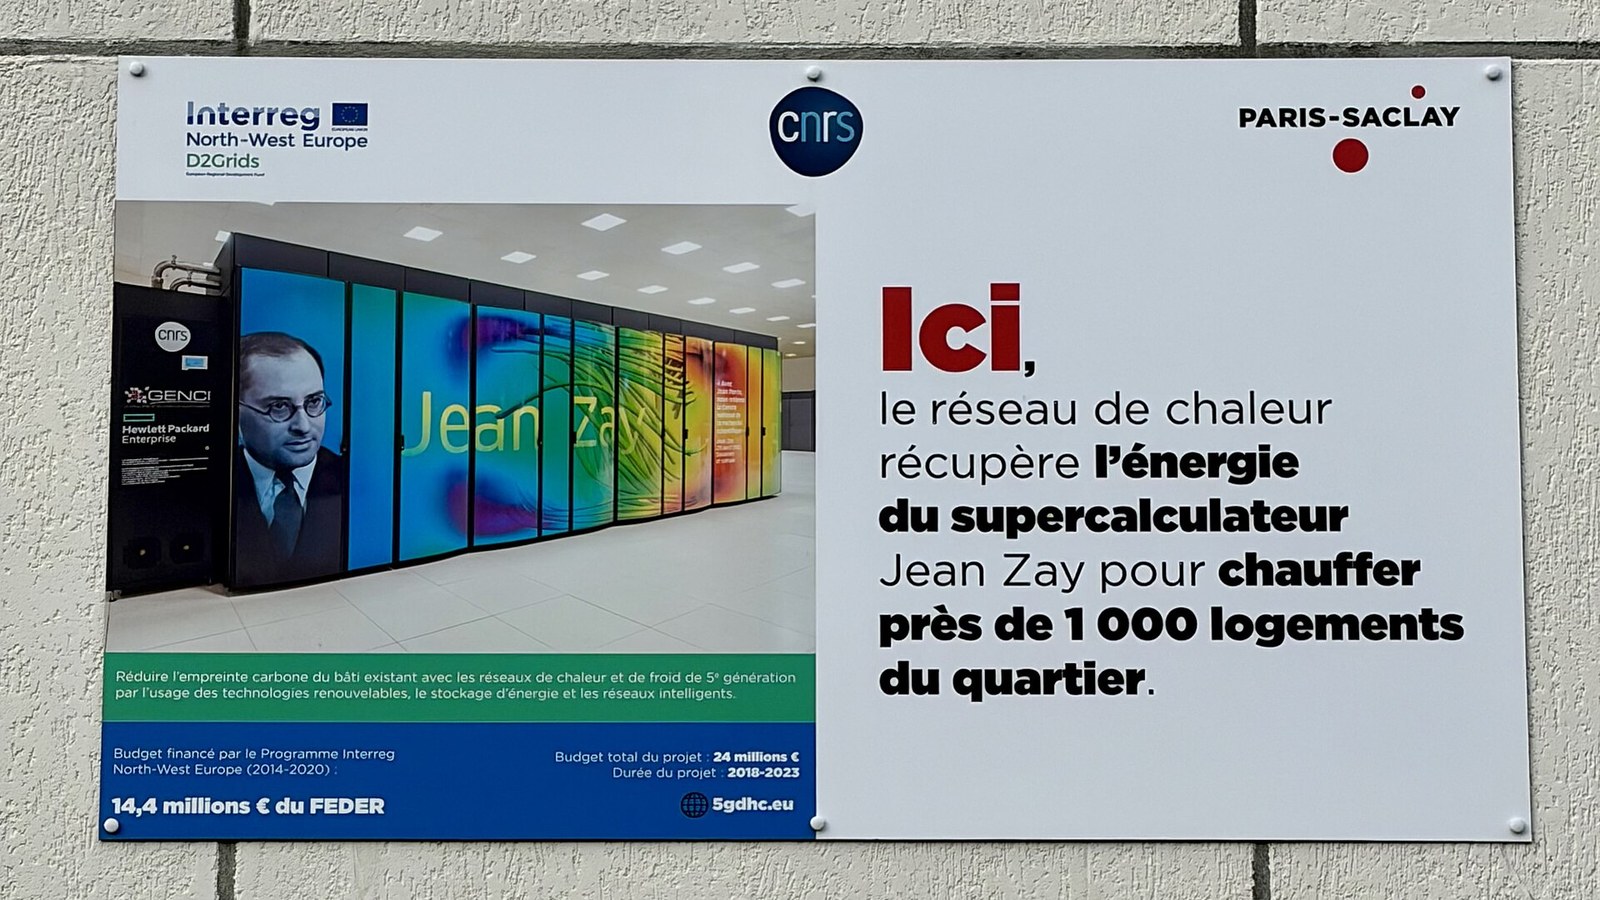
Olala mini a été entraîné sur trois supercalculateurs publics européens, Jupiter, MeluXina et Jean Zay, équipés de GPU GH200, A100 et H100. Ce soutien représente l'équivalent de 7 millions d'euros d'heures de calcul. Il a aussi donné naissance au laboratoire agentique d'OVH, OVHai LLM.
Le modèle est déjà utilisé par Qwant pour sa fonction de réponse flash : les réponses sont 20 % plus rapides et les coûts de fonctionnement divisés par trois par rapport au modèle précédent.
Vers Olala 1.1, puis 2.0
La version 1.1, attendue d'ici la fin de l'année, portera la fenêtre de contexte à 128 000 tokens et améliorera le raisonnement mathématique. Avec la version 2.0, qui dépassera les 100 milliards de paramètres, OVH vise trois domaines : les agents pour les entreprises (Olala alimentera OVHai Workspace), le DevOps cloud et la cybersécurité.
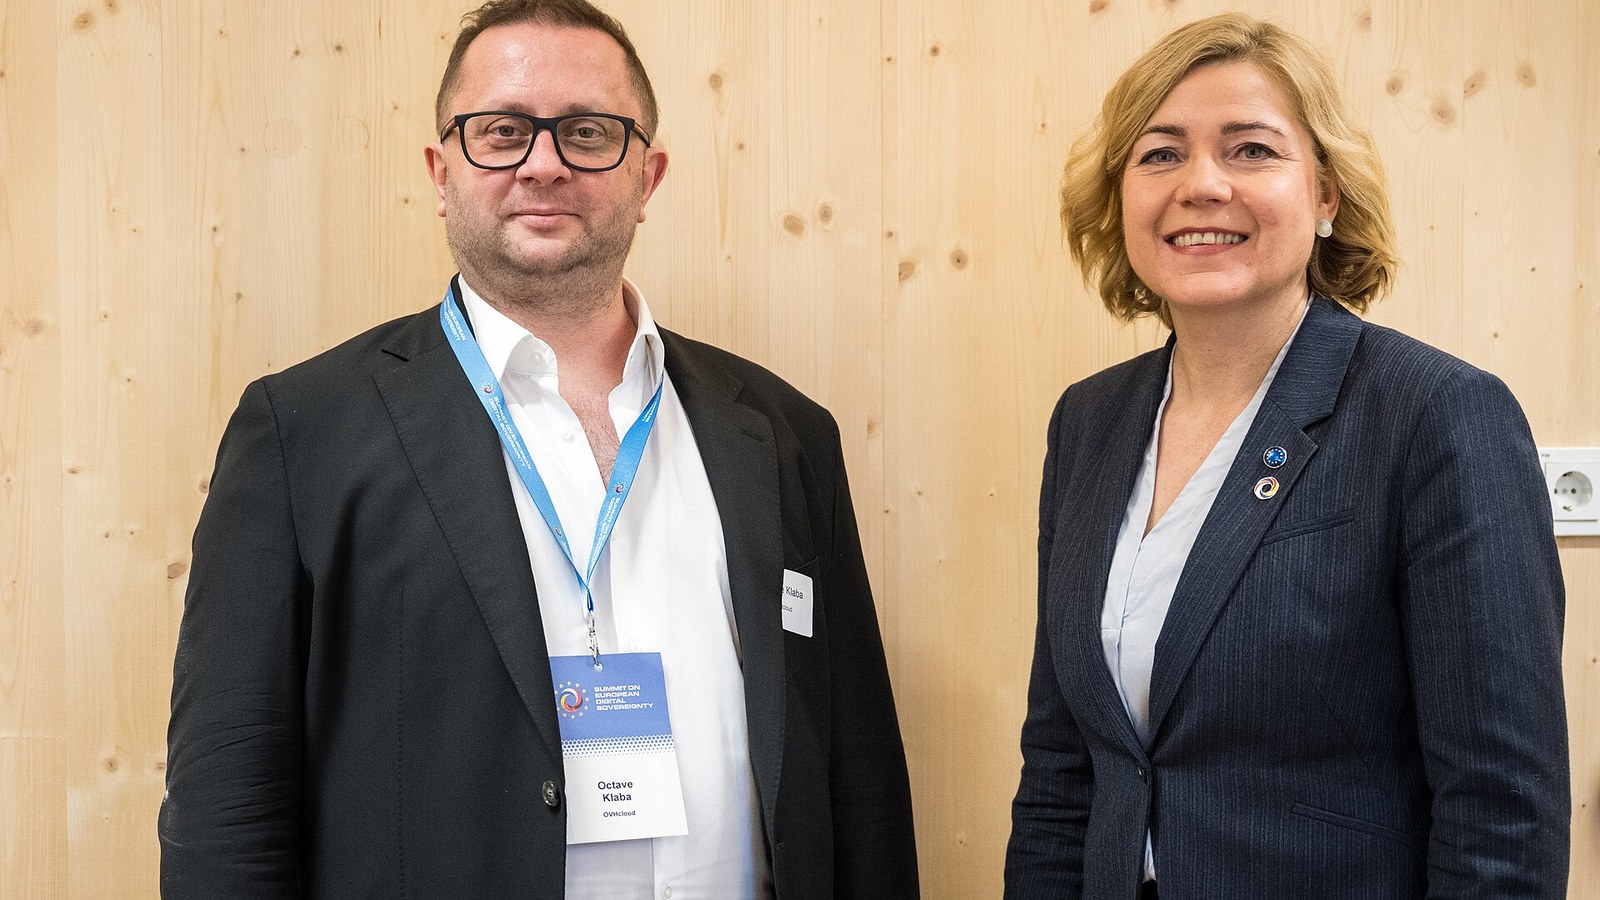
« On ne peut pas juste compter sur la générosité de certains Labs à partager leurs modèles LLM en open source dans les années à venir », explique Octave Klaba, qui rappelle que le coût d'un entraînement a été divisé par 20 en trois ans.
Sources
Communiqué de presse d'OVHcloud « OVH annonce Olala mini 7A1B » (17 novembre 2026). Images : Velvet (CC BY-SA 4.0), Forschungszentrum Jülich / Sascha Kreklau (CC BY 4.0), Stefanie Loos / Union européenne 2025 (CC BY 4.0), Clemcloum8 (CC0), via Wikimedia Commons.