Google TPU 8tx et TPU 8i Max : deux nouvelles puces d'IA pour les agents, quatre TPU lancés en un an
Tech · par Insight Nexus · publié le 10 novembre 2026
Le 8tx protège les données pendant le calcul, le 8i Max double calcul et mémoire avec deux puces ; Google ouvre aussi ses TPU à PyTorch.
Google ajoute deux TPU à sa huitième génération
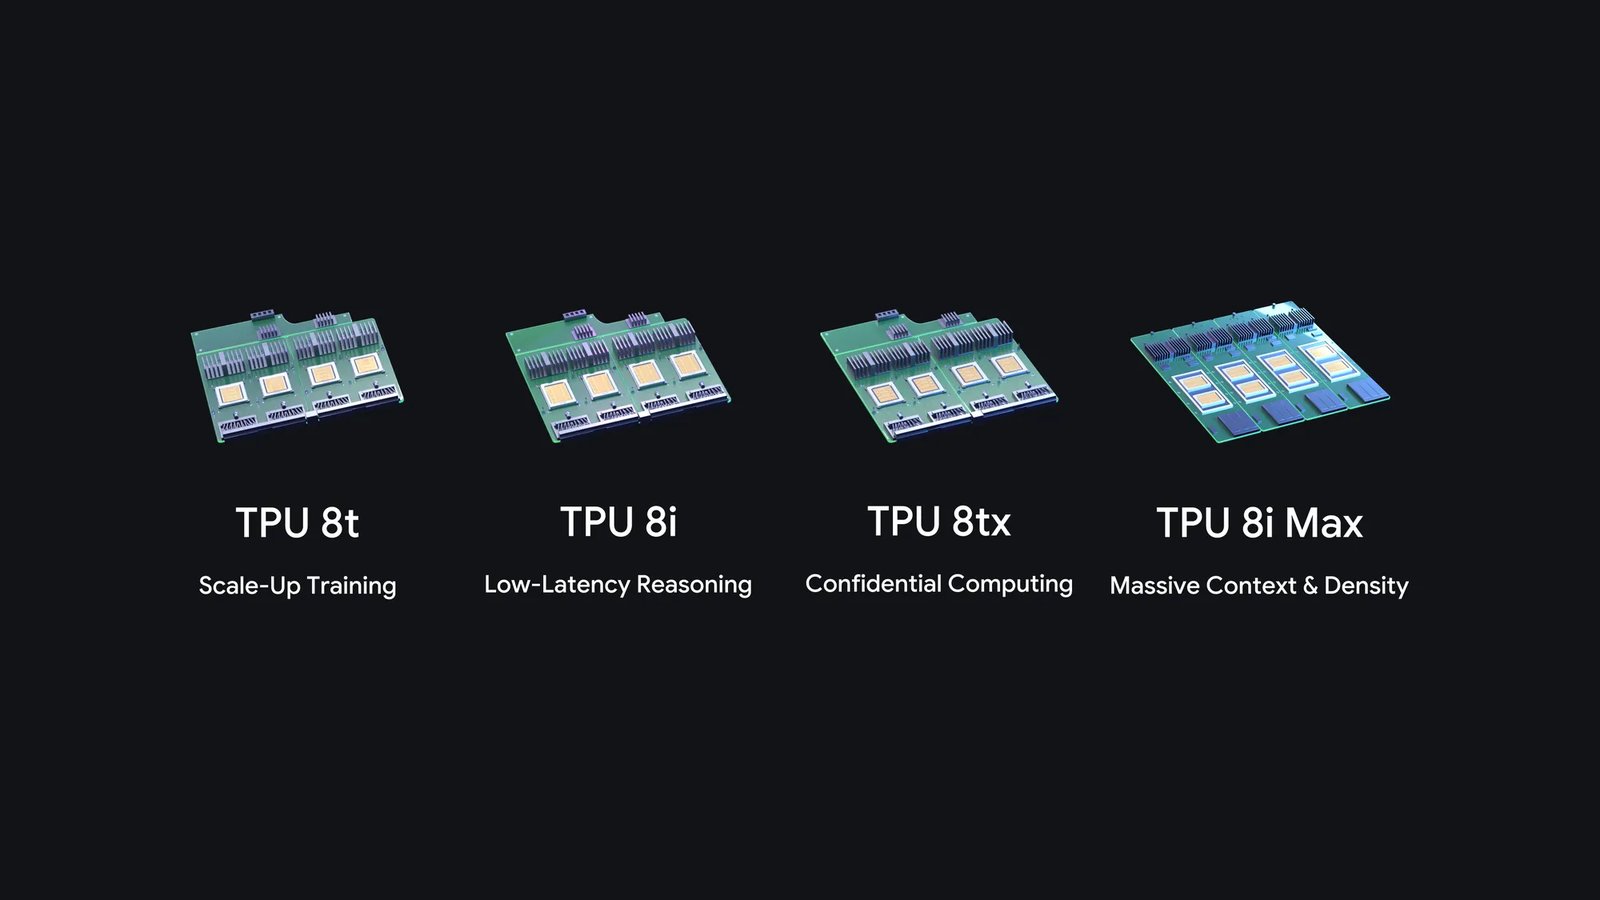
Google a présenté le lundi 9 novembre 2026 deux nouveaux systèmes de puces d'IA : le TPU 8tx et le TPU 8i Max. Ils rejoignent les TPU 8t (entraînement) et 8i (raisonnement en temps réel) annoncés plus tôt dans l'année. C'est la première fois que Google lance quatre systèmes TPU en une seule année, une annonce reprise par le compte officiel @Google sur X.
TPU 8tx : protéger les données même pendant le calcul
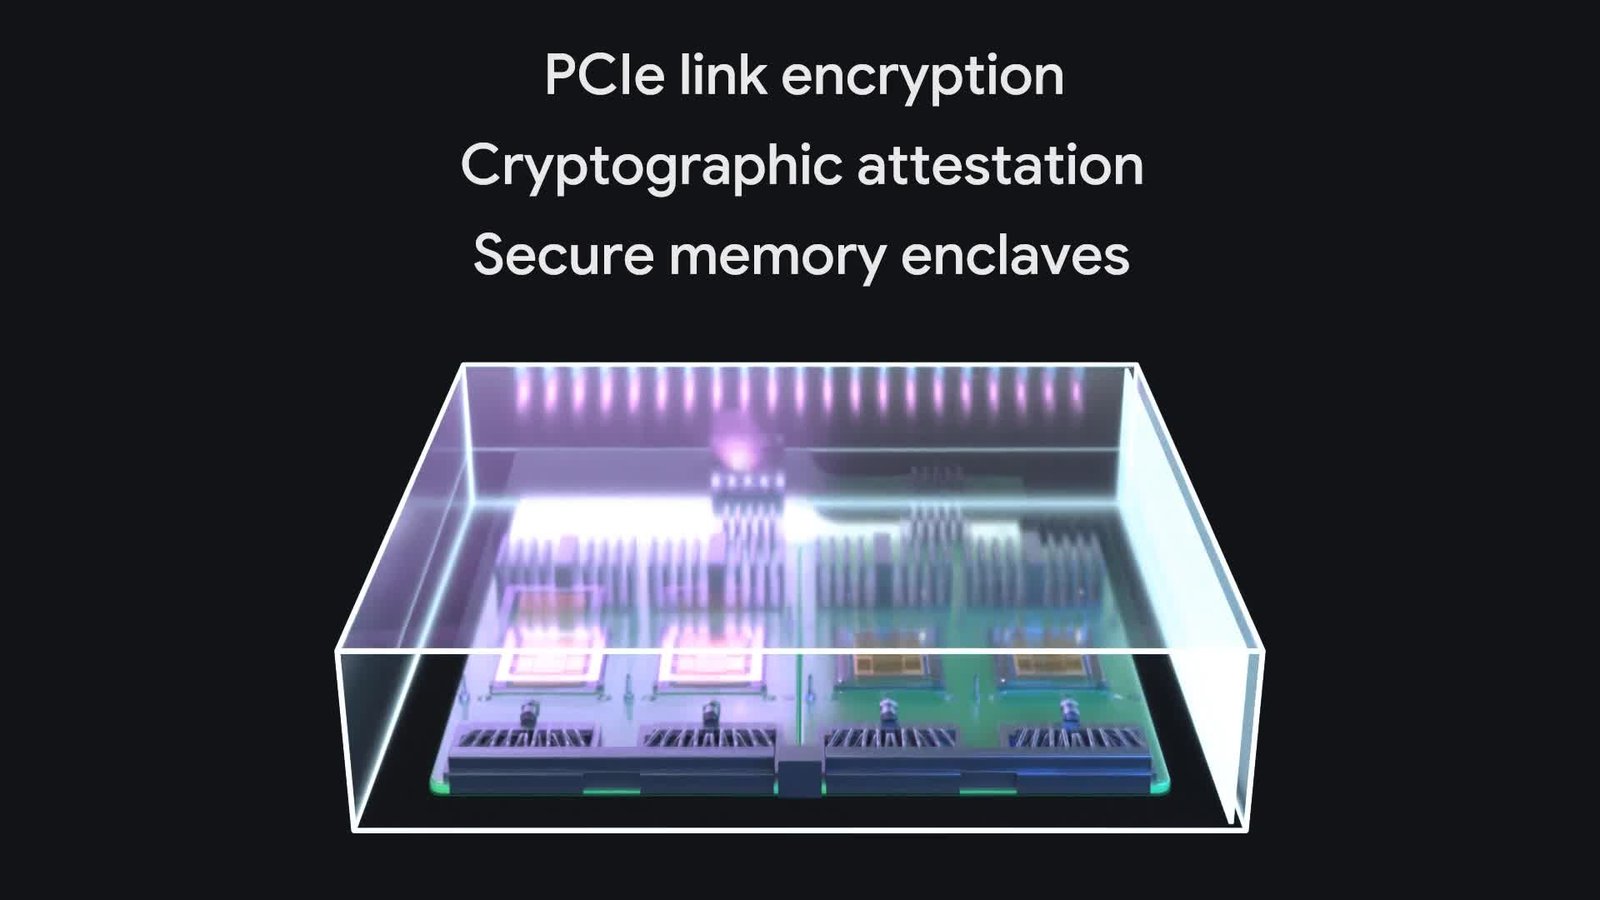
D'habitude, les données sont chiffrées quand elles sont stockées ou envoyées, mais pas pendant leur traitement en mémoire. Le TPU 8tx, construit sur la même puce que le TPU 8t et associé à des processeurs AMD EPYC de 5e génération, ajoute cette protection au niveau matériel : données sensibles et poids des modèles restent isolés même pendant le calcul. Il vise les entreprises réglementées et les gouvernements.
- Latence jusqu'à 2 fois plus faible que le TPU 8t, grâce au réseau Boardfly
- Affinage de modèles sur données privées, distillation et apprentissage par renforcement sur un seul système
- Chiffrement du lien PCIe, attestation cryptographique et enclaves mémoire sécurisées
TPU 8i Max : deux puces pour casser le « mur de la mémoire »
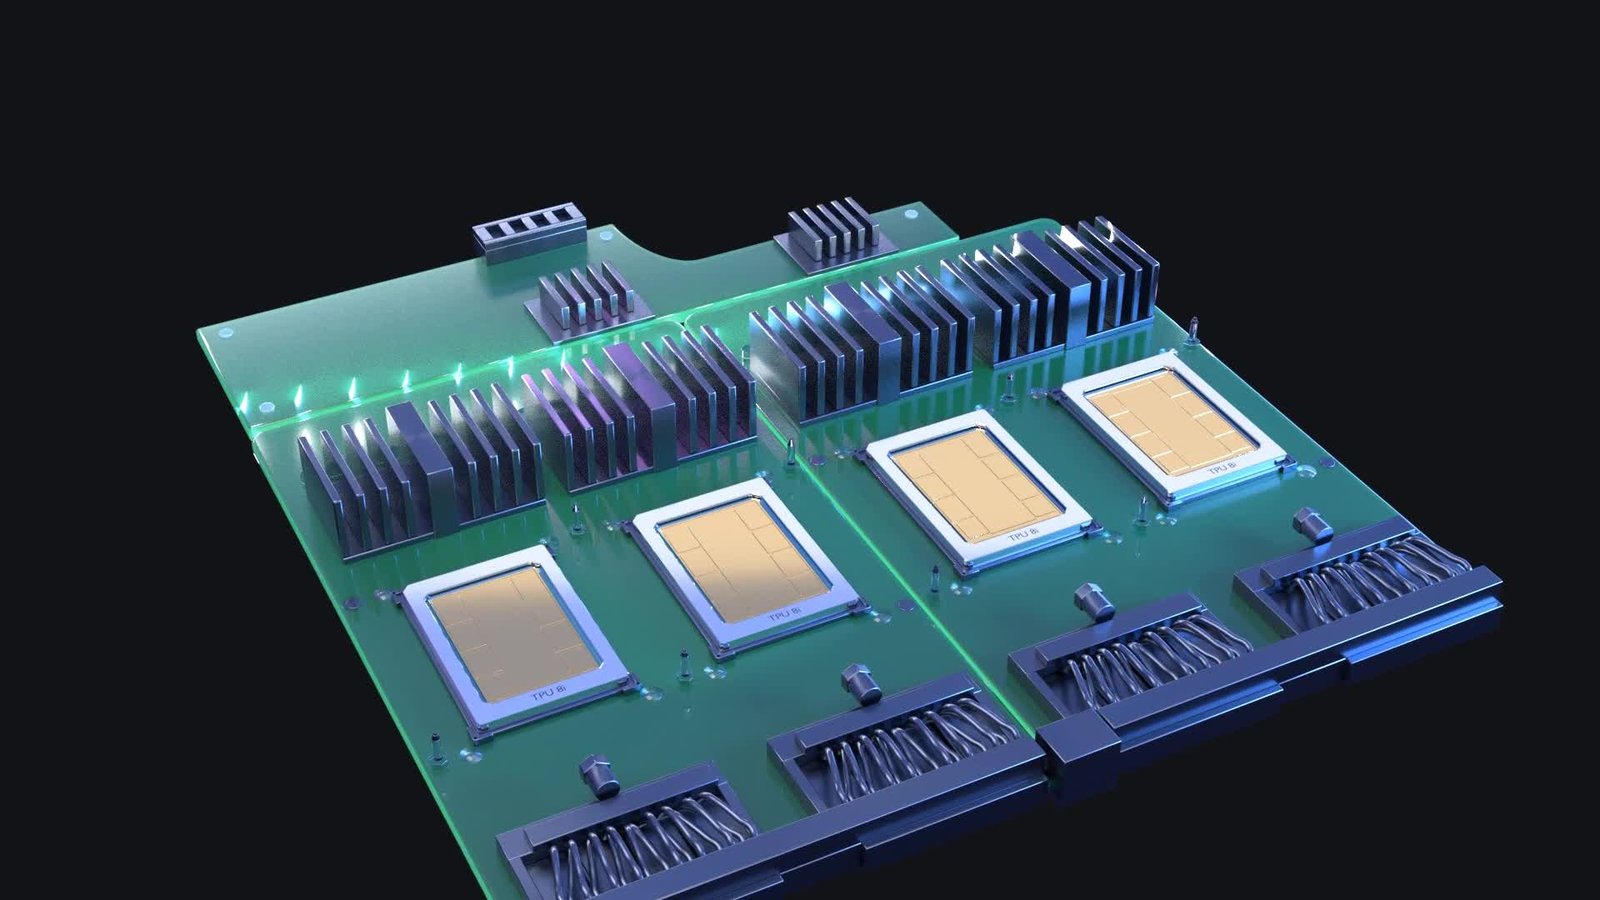
Quand des dizaines d'agents travaillent sur une base de code entière ou des heures de vidéo, c'est la bande passante mémoire qui bloque. Google a donc réuni deux puces TPU 8i dans un même boîtier. Résultat : deux fois plus de calcul, de SRAM et de bande passante HBM que le TPU 8i, et deux fois plus de silicium dans le même espace de baie, pour mieux gérer les très grandes fenêtres de contexte.
Des TPU plus faciles à utiliser
Google veut aussi rendre ses puces aussi simples qu'un matériel classique. TorchTPU permet de faire tourner du code PyTorch et des modèles Hugging Face sans réécriture, avec vLLM et SGLang. Une suite d'agents open source (en préversion) s'intègre à Claude Code, Cursor ou Google Antigravity pour configurer et optimiser les TPU. Google publie aussi en open source TPU Sync, qui réduit de plus de 90 % la latence de transfert du cache KV et le délai avant le premier token. Les TPU comptent déjà près de 100 clients, des laboratoires d'IA aux universités.
Sources
Blog officiel de Google (9 novembre 2026) et compte @Google sur X. Images : Google (visuels et vidéos officielles du blog).