Edge0-145B : un modèle d'IA ouvert de 145 milliards de paramètres qui tourne sur un seul GPU grand public
IA · par Insight Nexus · publié le 13 novembre 2026
Edge0 publie Edge0-145B et Edge0-120B, des modèles à poids ouverts pour le code et les agents en local : 29 Go de mémoire, plus de 120 tokens/s sur RTX 5090 D.
Un modèle de 145 milliards de paramètres qui tourne en local
La société Edge0 a publié le 12 novembre 2026 deux modèles d'IA à poids ouverts : Edge0-145B et Edge0-120B. Elle a aussi mis en ligne son moteur d'inférence et ses outils de déploiement. Edge0 présente Edge0-145B comme le premier modèle ouvert de 145 milliards de paramètres pensé pour fonctionner sur un ordinateur personnel. Selon elle, il rivalise en code, en raisonnement et en tâches d'agent avec certains modèles qui ne tournent que dans le cloud.
Les poids sont disponibles sur Hugging Face. Une application de bureau, Edge0 Chat, est proposée sur Windows. Le serveur local fonctionne avec les API d'OpenAI et d'Anthropic, ce qui permet de le brancher sur des outils existants.
Des scores proches des modèles du cloud
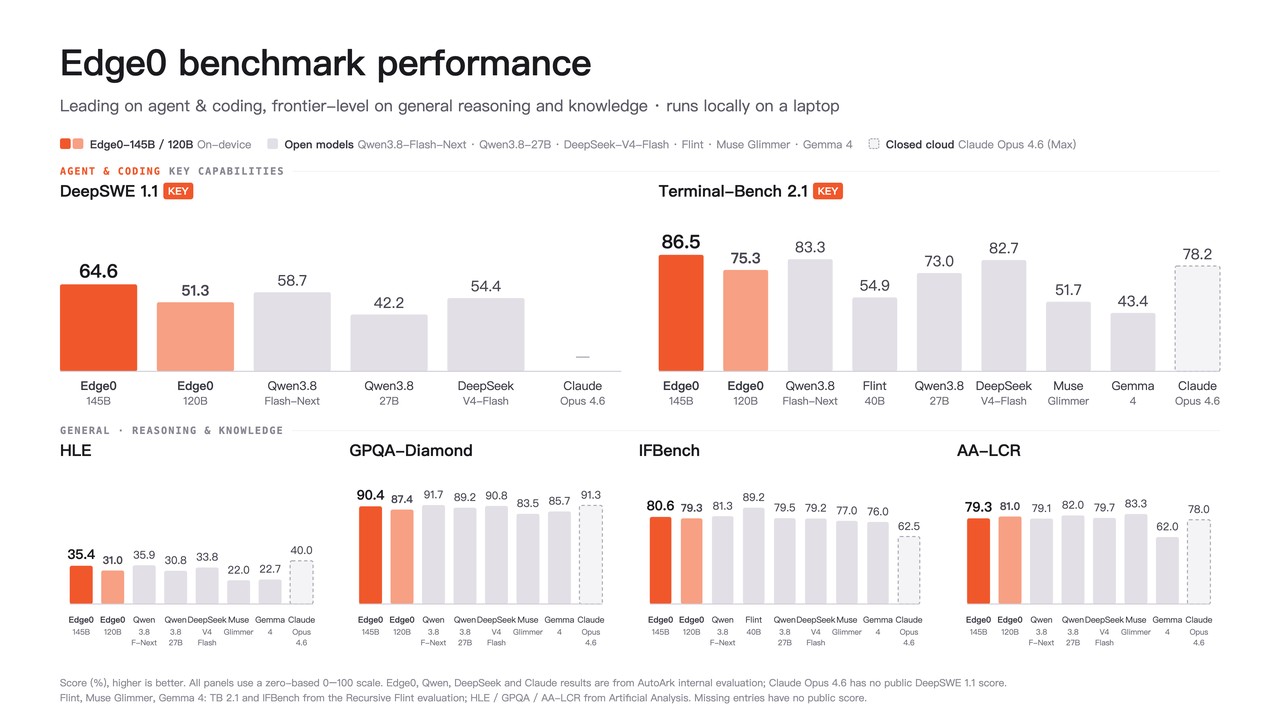
D'après les évaluations internes d'Edge0, Edge0-145B obtient 64,6 sur DeepSWE 1.1, contre 58,7 pour Qwen3.8-Flash-Next et 54,4 pour DeepSeek-V4-Flash-0731. Il atteint 86,52 sur Terminal-Bench 2.1 (78,2 pour Claude Opus 4.6 Max), 90,4 sur GPQA-Diamond (91,3 pour Claude) et 80,6 sur IFBench. Sur HLE, il reste derrière avec 35,4 contre 40,0 pour Claude.
Ces chiffres viennent de l'entreprise elle-même. Les scores de Qwen, DeepSeek et Claude ont aussi été mesurés par Edge0. Le protocole complet doit être publié avec le rapport technique.
Comment il tient dans un PC
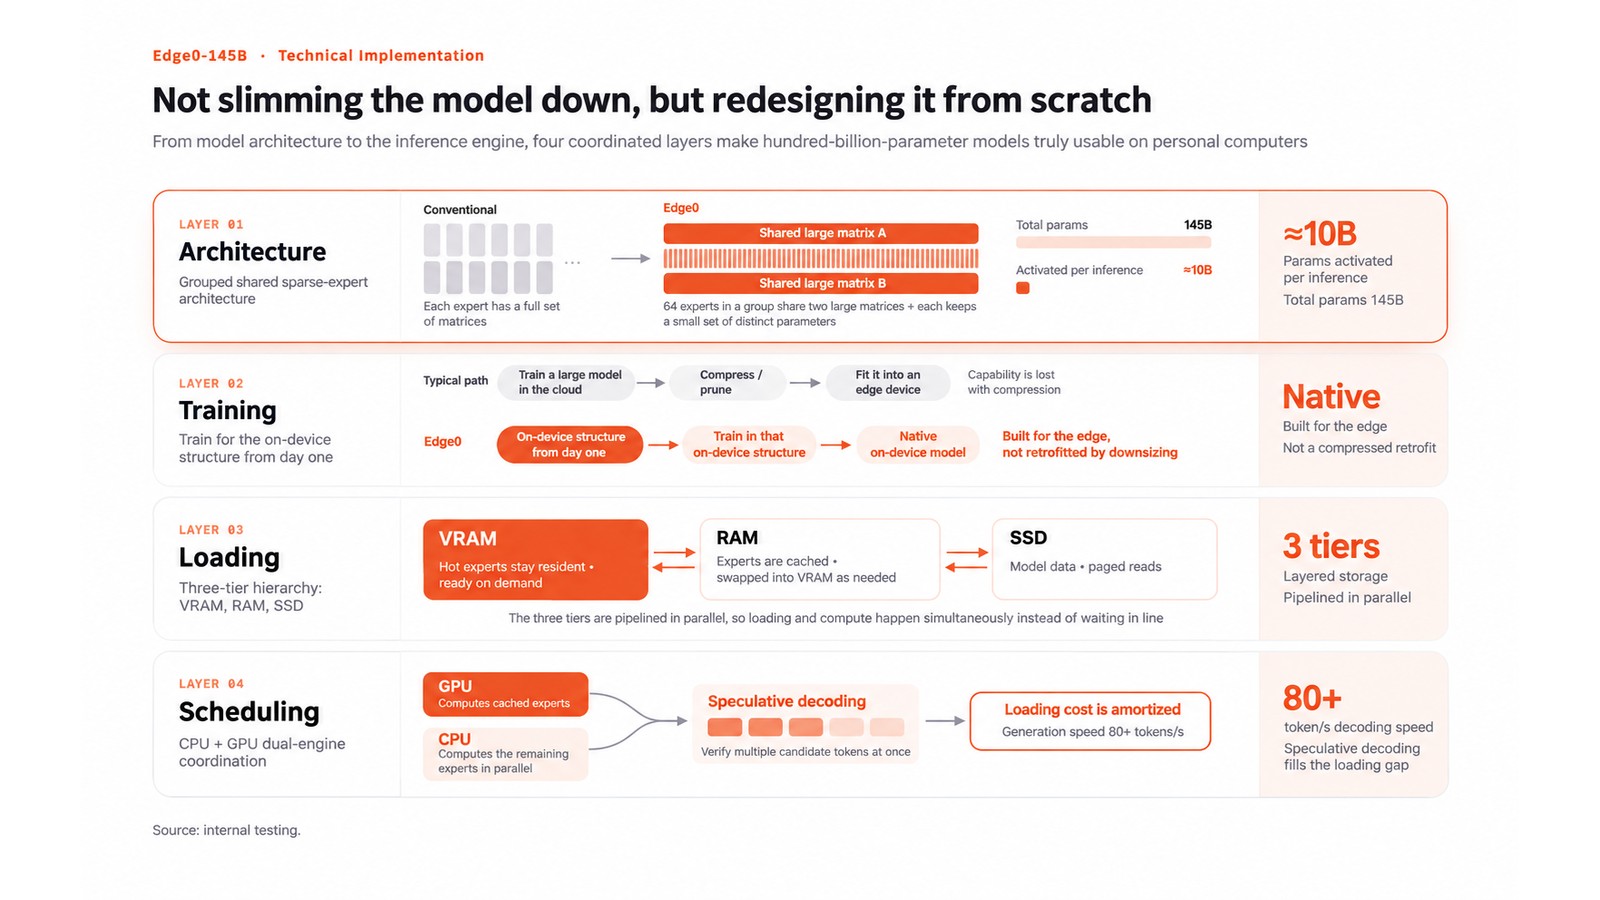
Le modèle est un mélange d'experts : sur ses 145 milliards de paramètres, environ 10 milliards seulement travaillent à chaque étape. Il compte 48 couches et 512 experts par couche, dont 10 sont choisis pour chaque token. Il a été entraîné directement en 4 bits et accepte un contexte de 256 000 tokens.
- Experts partagés : chaque groupe d'experts partage deux grandes matrices, ce qui réduit le volume de poids à stocker et à déplacer.
- Trois niveaux de mémoire : les experts les plus utilisés restent dans la mémoire du GPU, les autres sont chargés depuis la RAM ou lus sur le SSD quand il le faut.
- CPU et GPU ensemble : le processeur prend une partie du calcul, et le décodage spéculatif vérifie plusieurs tokens à la fois.
Quel matériel faut-il ?
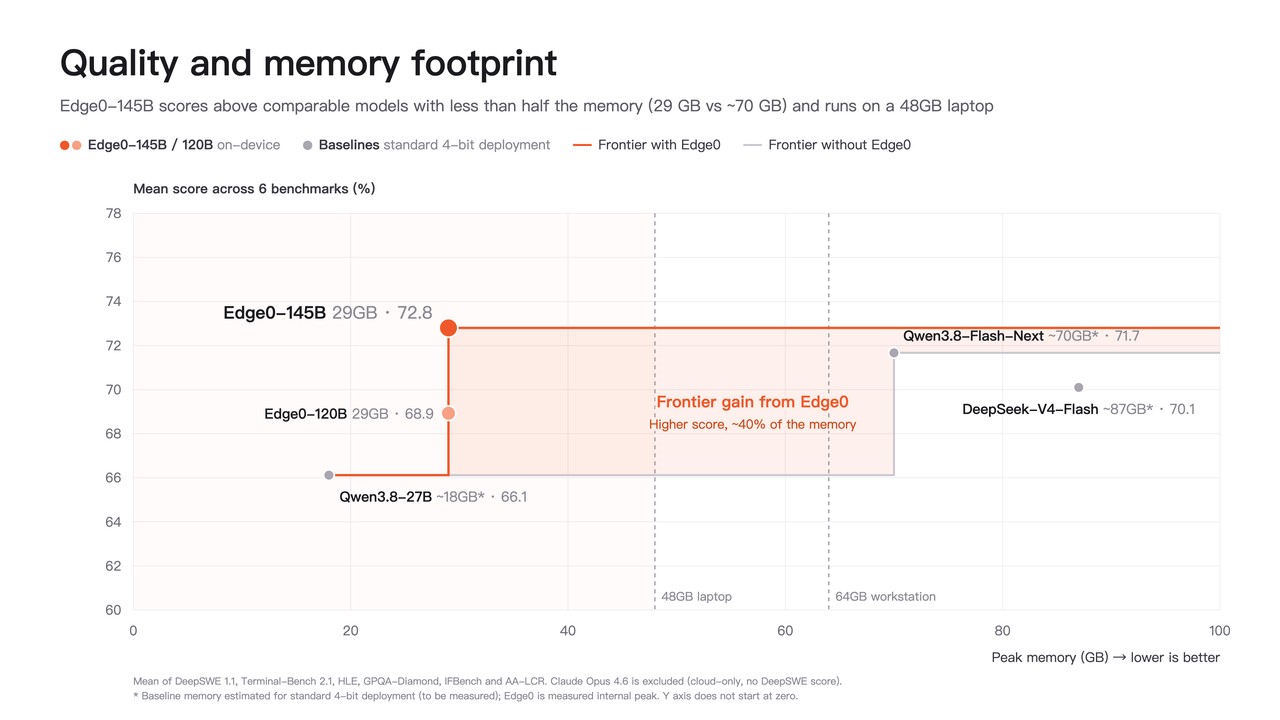
Selon Edge0, le modèle utilise 29 Go de mémoire au maximum et peut fonctionner sur un portable de 48 Go. Sur Hugging Face, la version Q3_K est mesurée à 121 tokens par seconde en mode agent sur une RTX 5090 D 24 Go, et à 92 tokens par seconde sur une RTX 4090. Elle a aussi été testée avec seulement 16 Go de mémoire vidéo et 20 Go de RAM, à environ 45 tokens par seconde.
Pour l'instant, les instructions visent les GPU NVIDIA sous Linux ou Windows avec CUDA 13. Edge0 donne aussi des mesures sur une puce Apple M2 Ultra, mais précise que cela ne signifie pas qu'une version macOS est disponible.
Ouvert, mais pas libre
Le code du moteur est sous licence Apache 2.0. En revanche, le modèle lui-même est diffusé sous la Edge0 Community Model License 1.0, et certaines parties restent soumises à la licence de Qwen. On peut l'utiliser à titre personnel, pour la recherche ou en interne, et exploiter commercialement ce qu'il produit. Mais il faut une licence écrite d'Edge0 pour le vendre, l'intégrer à un produit commercial ou en faire un service payant.
Pour montrer ce dont il est capable, Edge0 a publié des démonstrations entièrement locales : une vidéo explicative produite en moins d'une heure, une scène 3D de Manhattan construite dans Blender et des petits jeux jouables.
Sources
Blog officiel Edge0 (12/11/2026), fiche Hugging Face Edge0-145B-q3k, dépôt GitHub Edge0-AI. Images : Edge0.