Agent Compute Engine : Google lance l'infrastructure qui fait tourner les agents Gemini, bientôt ouverte aux entreprises
IA · par Insight Nexus · publié le 26 octobre 2026
Annoncé le 22 octobre 2026 : une micro-VM isolée par agent, aucun identifiant dans le bac à sable, quatre identités par agent et Agent Substrate en open source pour Kubernetes.
Google transforme l'infrastructure de Gemini en service cloud
Google a annoncé le 22 octobre 2026, lors de la conférence AGNTCon + MCPCon, Agent Compute Engine. C'est un service de calcul conçu pour les agents IA, qui fait déjà tourner l'agent Gemini pour les tâches professionnelles. Les clients de Google Cloud pourront l'utiliser en préversion dans les prochains mois.
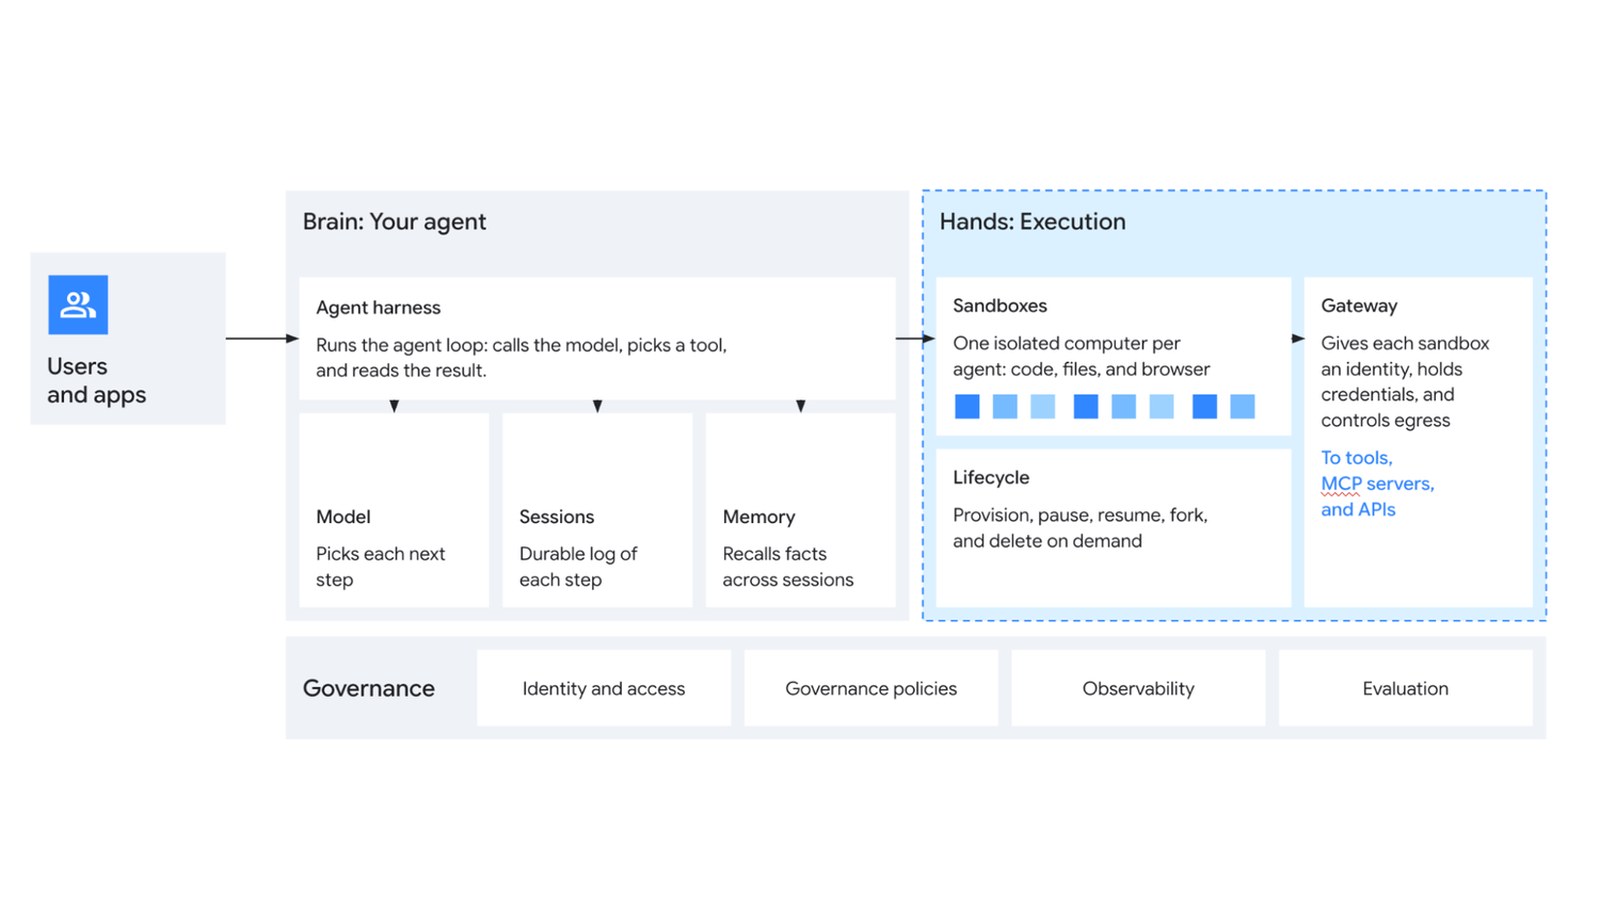
Le principe est simple : chaque agent reçoit son propre ordinateur, avec un système de fichiers, des langages de programmation, un navigateur et un accès réseau contrôlé.
Le « cerveau » et les « mains » séparés
Google découpe chaque agent en deux parties. Le harnais, ou « cerveau », appelle le modèle et décide de la suite. Le bac à sable, ou « mains », exécute le code, les commandes et le navigateur. Le cerveau reste toujours en dehors du bac à sable, qui ne fait qu'exécuter les ordres reçus.
Des micro-VM qui se mettent en pause
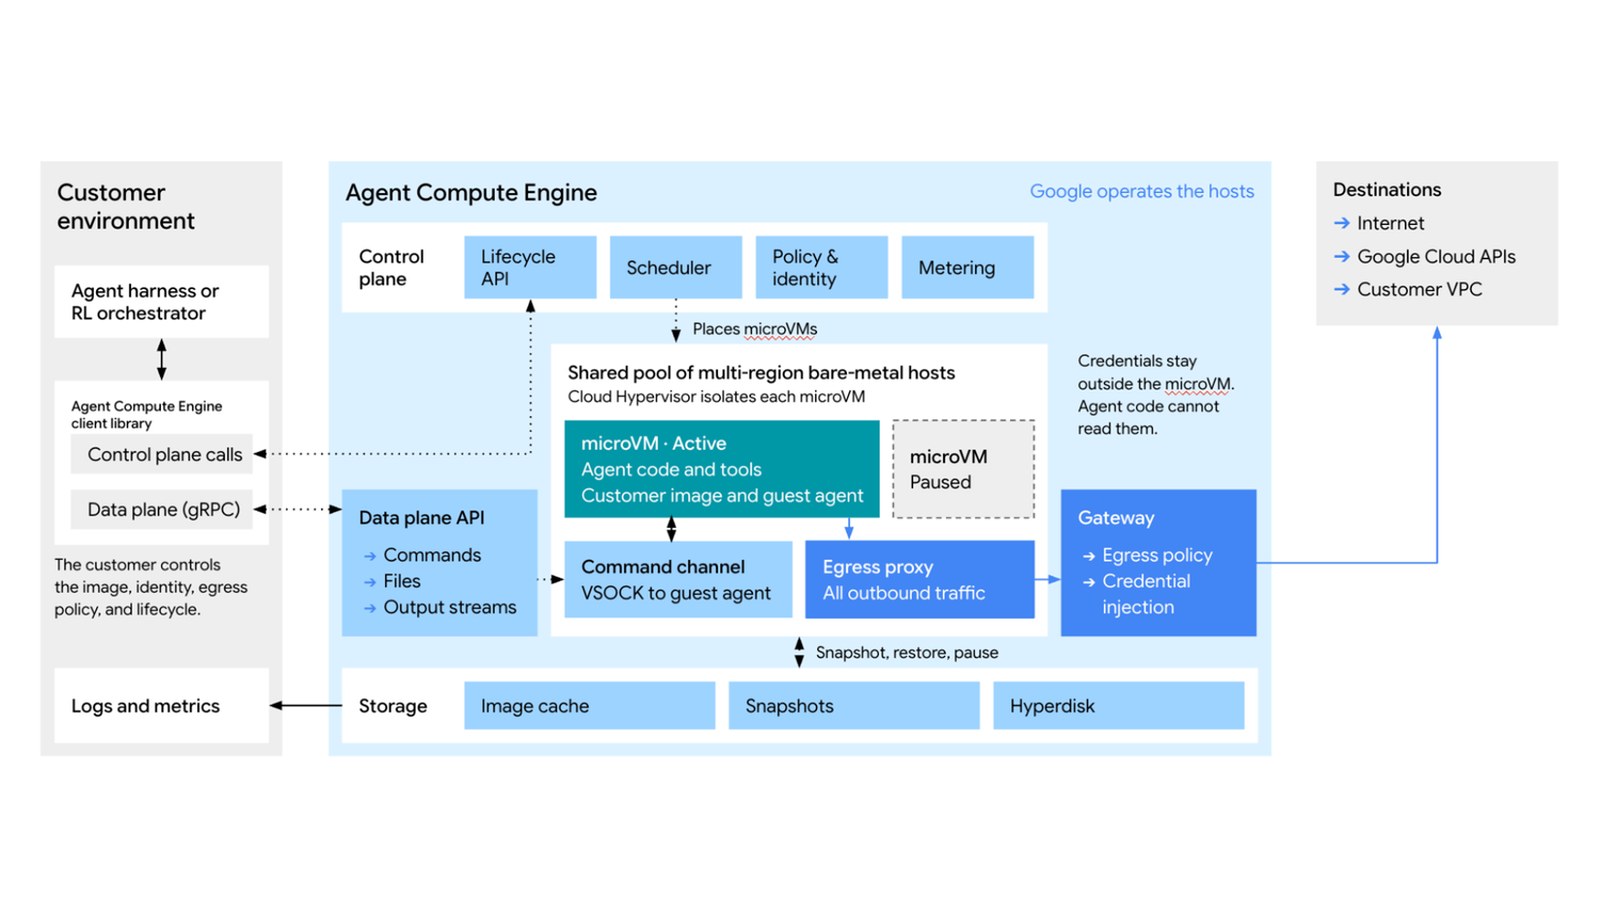
Chaque agent tourne dans une micro-VM isolée par le matériel, qui démarre rapidement. Quand l'agent « réfléchit » ou attend une réponse humaine, sa machine est mise en pause, puis relancée depuis un instantané. Plusieurs agents partagent un même modèle de système grâce à la copie sur écriture, ce qui réduit les coûts. Chaque micro-VM a aussi son propre disque Hyperdisk pour garder son travail d'une session à l'autre.
Une sécurité pensée contre les attaques par prompt
Google part d'une règle : supposer qu'un attaquant contrôle tout ce qui se trouve dans le bac à sable. Exemple donné : un agent lit un e-mail piégé qui lui demande d'envoyer des clés d'API. Pour limiter les dégâts, le bac à sable ne contient aucun identifiant, ni mot de passe, ni jeton. Il n'a pas non plus de carte réseau classique : tout passe par un proxy externe qui vérifie chaque requête.
Quatre identités par agent
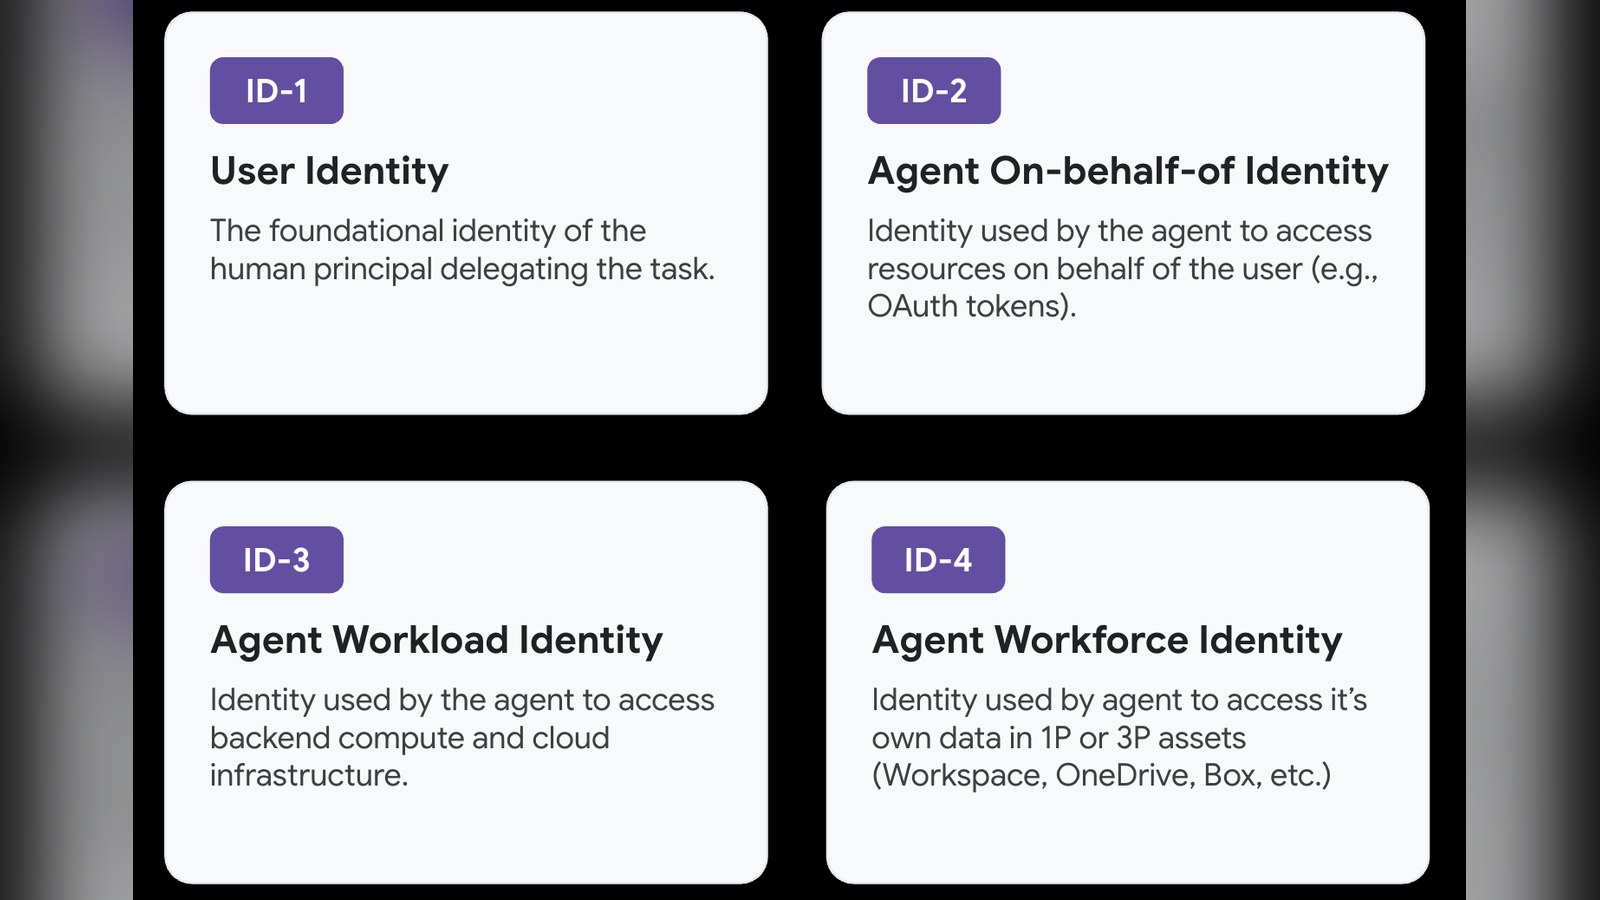
Pour savoir « qui » ouvre un document, Google crée quatre identités : celle de l'utilisateur, celle de l'agent qui agit en son nom, celle utilisée pour l'infrastructure cloud et celle qui accède aux données de travail (Workspace, OneDrive, Box…). Le bac à sable ne détient jamais l'identité qui ouvre l'accès aux données.
Agent Substrate : la version open source pour Kubernetes
Google publie aussi Agent Substrate, un environnement open source pour GKE et tout cluster Kubernetes. Google annonce jusqu'à 10 fois plus de densité que le calcul classique. Dans un test avec 200 000 agents, il a tenu 500 activations par seconde, avec moins de 500 ms pour suspendre ou reprendre un agent. Il fonctionne avec Claude Code, OpenClaw ou Hermes, et Nous Research l'utilise déjà.
Plus de contrôle sur les agents en entreprise
Google étend aussi ses outils de gouvernance (Agent Gateway, Agent Registry, Agent Identity) à d'autres clouds et aux postes de travail, pour des agents de code comme Claude Code ou Antigravity CLI. Des outils pour suivre la consommation de jetons et orienter chaque requête vers le bon modèle arrivent en préversion ce trimestre.
Sources
Blog Google Cloud : « Introducing Agent Compute Engine and expanding agent governance » et « Inside Agent Compute Engine » (22 octobre 2026). Images : Google Cloud.